主观评语
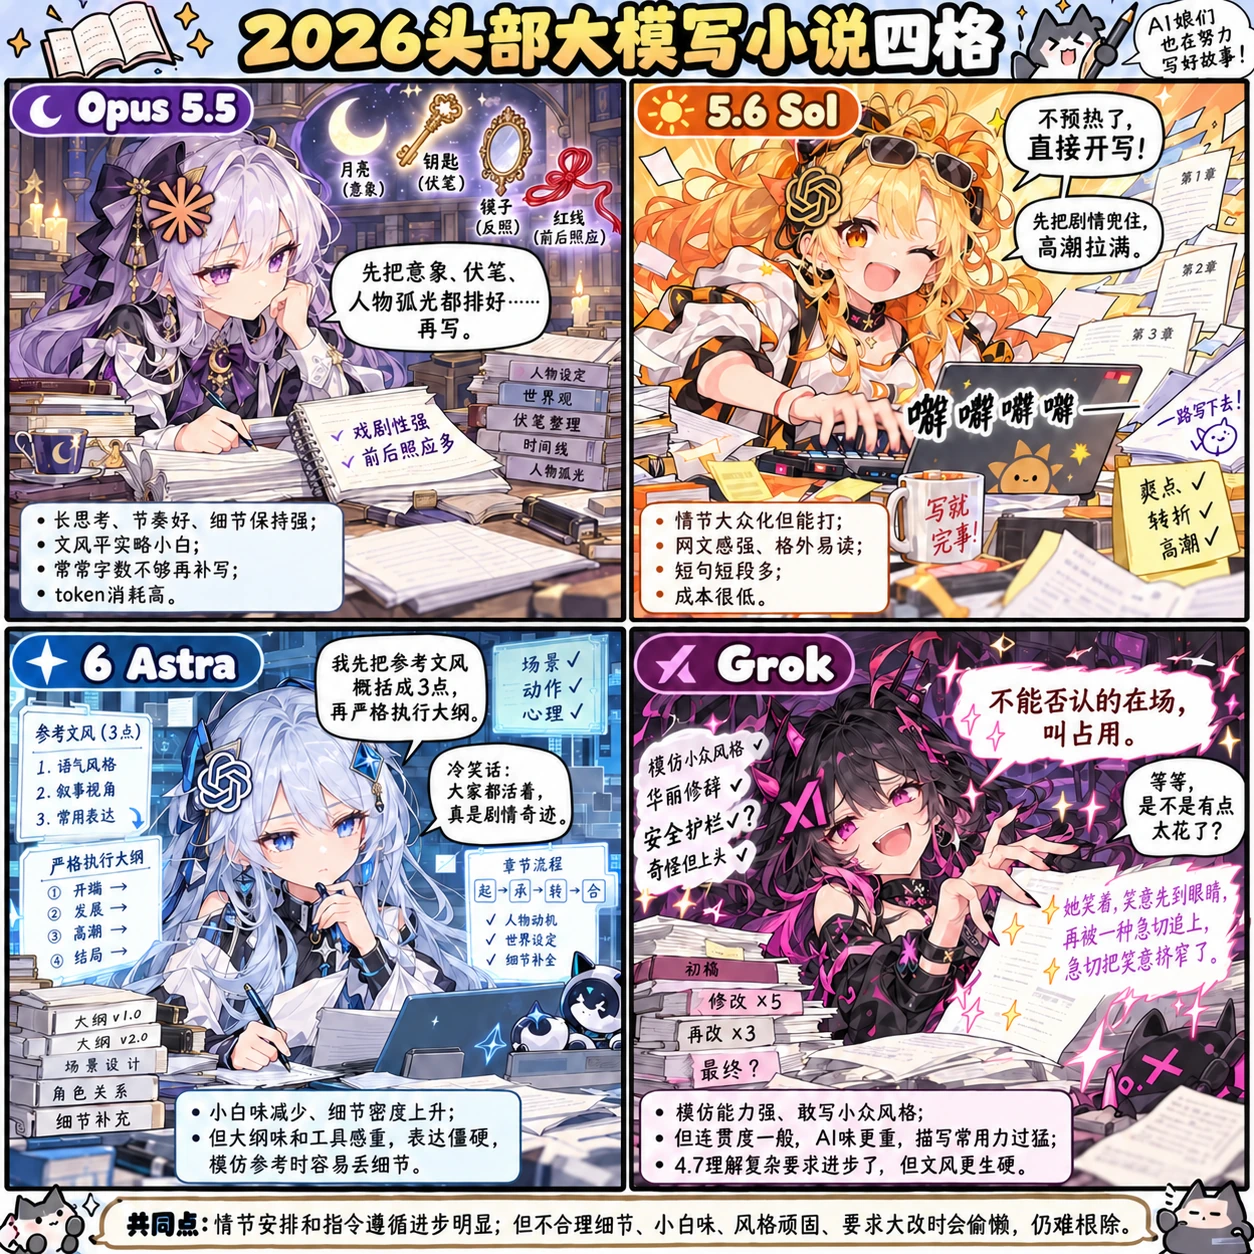
2026年头部大模的情节安排和指令遵循的能力飞跃,默认表达的廉价网文味有所减轻,Claude和5.6 Sol也没有因为适应agent汇报风而失去表达能力(GPT 6系列目前确实有问题),自主创作短篇小说(需要一定情节架构和节奏把控能力,不是不足万字的短文)的水平是有长足进步的,wish writing的可用性大幅提高。但即使是头部大模,不合理细节和描写还是不能通过自纠根除,小白表达还难以根除,影响严肃或沉郁题材的可用性。同一模型只要不大幅调整prompt就很难让大致风格和自主设计的情节发生实质变化,后续轮次要求大改时也倾向于偷懒。
Claude Fable 5.1 / Opus 5.5:非常喜欢设计意象和前后照应,情节戏剧性较强,句子长短交织节奏较好,默认文风平实略小白,能模仿其他风格但这种表达底色难以抑制。会先进行长思考安排好风格人物情节再写,倾向于低估字数需要补写,总成本较高(这里指的主要是各类token消耗量,而非模型本身定价档位)。Fable 5.1更能保持复杂要求中所有的细节并理解整体的预想(如分析者),但也可能因为过于强调其中某个点而走形(如双线)。
GPT 5.6 Sol:情节设计比较大众化,不太用技巧,高潮戏剧性较强,有时内容安排的详略不得当。短句和短段偏多,章节划分较零碎,每一节的首尾倾向于用短而让人意外的表达营造氛围,网文感强,格外易读。能模仿其他风格但这种表达底色难以抑制。相比Claude更常用美式大众文学中常见的略显荒诞的小幽默。即使设置xhigh思考强度,也会几乎没有预先规划和准备直接开写,即使如此情节也基本能兜住,字数估计比较准确,总成本很低。
GPT 6 Astra / 6.1 Sol:相比5.6 Sol,网文式渲染明显减少,细节描写密度大增,其中埋藏的小twist较多,但合理性得不到保证(如面对面口语中说“收到了”,杯子不适合接触饮用水),情节和对话工具感严重(大纲味浓,只为满足故事发展的要求),表达非常僵硬,导致人物塑造很不鲜活。对参考文本会先概括成几个点,再模仿自己概括的风格,在此过程中会损失大量参考文本的细部特征,且概括的方向可能也有偏差,导致对参考文本的模仿片面甚至错误,行文风格非常顽固、无法拉近与参考的距离。不附加解释的荒诞冷幽默进一步增多,倾向于用冷幽默处理戏剧高潮,符合美式大众向主流风格但在中文里的效果不太好。中文角色名多样性明显提高。自主规划分配的轮数较多(即每次写的字数更少),平均成本略增。6 Astra的细节描写比6.1 Sol更多,场景、动作和角色思维描写都更频繁,但反而导致表达僵硬的问题更为突出(典型的是分析者),对故事复杂度和感染力的作用不大,且Astra会努力尝试写到要求字数区间的中部,几乎总会触发补写。
Grok 4.6:情节设计比5.6 Sol更大众化,重戏剧性,不同章节的连贯度也有差距。廉价的AI味表达更多(“不能否认的在场,叫占用”),喜好用比较花哨的描写方式,但常显得过于刻意(“她笑着,笑意先到眼睛,再被一种急切追上,急切把笑意挤窄了”)。风格模仿能力较强,从情节设计到具体描写都更能逼近小众风格(但仍无法控制上述表达问题),安全护栏也较松。思维链较长且反复,会在thinking阶段大量模拟写正文,倾向于低估字数,总成本较高。
Grok 4.7:相比4.6更多的参数让情节设计和复杂指令的理解能力有所进步,但原有的表达问题反而更加严重:语气变得很平、短句非常多,常常将常见的二字词简化为一个字,还倾向于用不太贴切的借代和通感,英文直译的生硬感也更强,不过这些问题反而在描绘边缘人群时营造出合适的怪味(如工程师)。小众风格的模仿能力下滑,安全护栏明显收紧(思维链中会反复验证)。